この記事は次を読んでいる前提で書いています。
検証バージョン: scikit-learn 1.9.1 検証日: 2026-09-26
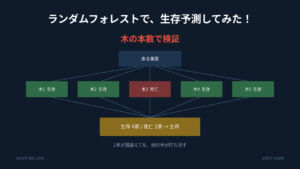
ランダムフォレストは、決定木を何本も作って多数決を取る手法です。木を増やせば精度が上がりそうですが、何本あれば足りるのかは動かさないと分かりません。
そこで Kaggle の Titanic で生存予測をしながら、木の本数を1本から1000本まで変えて実測しました。
結果として、10本あたりで頭打ちになりました。決定木1本との比較や、深さとの関係も合わせて確かめています。
使うデータ
Kaggle とは
機械学習の課題が公開されているサイトです。企業や研究機関が出した予測の課題に対して、世界中の参加者が精度を競います。
課題ごとにデータが配布されていて、参加すれば誰でもダウンロードできます。無料です。
今回使う Titanic は、その中でも入門向けとして用意されているものです。常時開催されていて締切がありません。

データの取得
アカウントを作り、コンペのページで Join してルールに同意すると、データのページ からダウンロードできます。
コマンドで取ることもできます。
kaggle competitions download -c titanic配布されるのは3つのファイルです。この記事で使うのは train.csv だけです。
train.csv               891 行。答えつき
test.csv                418 行。答えなし
gender_submission.csv   提出フォーマットの見本
データの中身
1行が1人で、次の項目が入っています。
PassengerId  乗客の番号
Survived     生き残ったか。0 が死亡、1 が生存。これを予測する
Pclass       客室の等級。1 が上級、3 が下級
Name         氏名
Sex          性別
Age          年齢
SibSp        同乗している兄弟姉妹と配偶者の人数
Parch        同乗している親と子の人数
Ticket       チケット番号
Fare         運賃
Cabin        客室番号
Embarked     乗船した港
891人のうち、生き残ったのは342人で38.4パーセントでした。
この記事で使うのは、次の6列です。氏名やチケット番号は文字列なので、今回は外しました。
性別、客室等級、年齢、運賃、兄弟配偶者の数、親子の数ランダムフォレストとは
決定木を何本も作り、それぞれに予測させて、多数決で決めます。
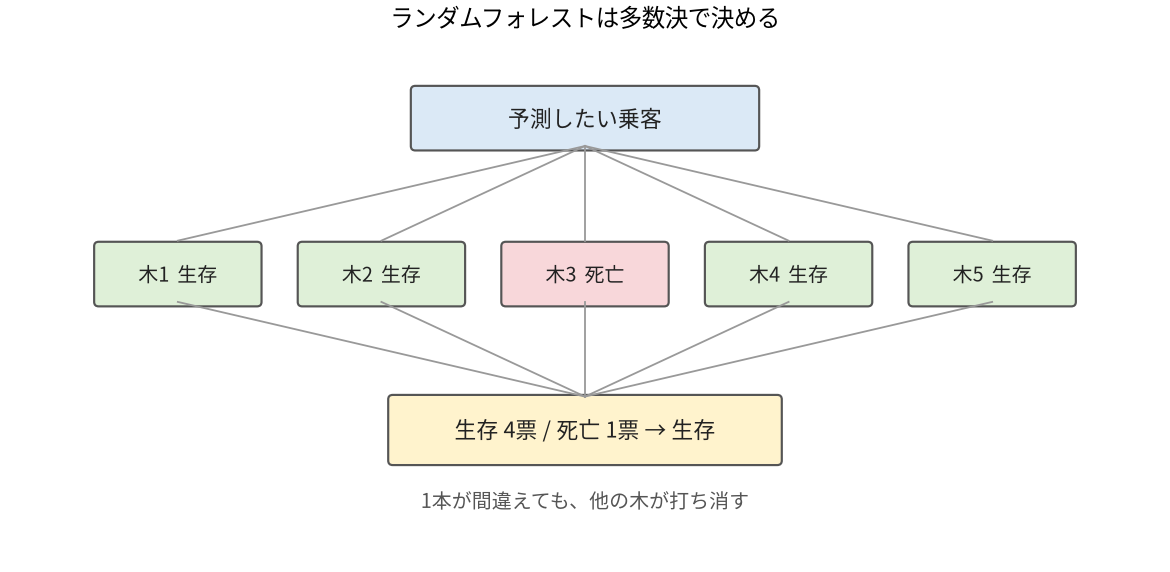
ただ、そのままでは多数決になりません。決定木は分け方の手順が決まっているので、同じ891人を渡せば、何度作ってもまったく同じ木ができます。300本作っても全部同じ木なので、多数決を取る意味がありません。
多数決が効くのは、木ごとに違う間違え方をするときです。1本が外した人を別の木が当ててくれるから、打ち消し合います。
そこで、1本作るたびに渡すものを変えます。変えるのは2つです。
| 木ごとに変えるもの | やり方 |
|---|---|
| 学習に使う人 | 891人の中から891回選び直す。同じ人が何度入ってもよい |
| 分岐で見られる列 | 6列のうち2列だけを、分岐のたびに選ぶ |
学習に使う人を、891人から選び直す
木に渡すデータを、木ごとに作り直します。891人の中から1人をランダムに選んで書き写す、を891回繰り返して、891行のデータを作ります。
一度選んだ人も候補に残したままにするので、同じ人が2回3回と選ばれることがあります。そのぶん、一度も選ばれない人が出ます。
5人を5回選ぶ場合で書くとこうなります。
元の5人        1  2  3  4  5
作ったデータ    3  1  3  5  1
5行のままですが、中身は1番が2行、3番が2行、5番が1行です。2番と4番は入っていません。
891人で同じことをすると、こう分かれました。
| 選ばれた回数 | 人数 |
|---|---|
| 0回 | 328人 |
| 1回 | 328人 |
| 2回 | 164人 |
| 3回 | 55人 |
| 4回以上 | 17人 |
渡す行数は891のまま変わりません。ただし顔ぶれは563人で、そのうち236人は2行以上を占めています。
行数を減らさないのが、このやり方の狙いです。仮に563人だけを渡すと、学習に使えるデータが3分の2に減って、その木が弱くなります。行数は891のままで、顔ぶれだけを入れ替えられます。
同じ人が2回入ると、その木の中ではその人が2人分の重みを持ちます。分岐を決めるときに2回数えられるので、その人に都合のよい分け方が選ばれやすくなります。逆に、選ばれなかった328人はその木にとって存在しません。
つまり木ごとに、どの乗客を重く見るかが変わります。ブートストラップと呼ばれる手法です。
分岐で見られる列を絞る
普通の決定木は、分岐を1つ作るたびに6列すべてを調べて、一番よく分かれる列を選びます。
ランダムフォレストでは、その前に6列から2列を抽選します。そして、その2列の中だけで一番よく分かれるものを選びます。
| 分岐 | 見ていい2列 | 選ばれた列 |
|---|---|---|
| 1つ目 | 年齢、運賃 | 運賃 |
| 2つ目 | 性別、親子の数 | 性別 |
| 3つ目 | 客室等級、兄弟配偶者の数 | 客室等級 |
1つ目の分岐では性別が候補に入っていないので、使いたくても使えません。2つ目では入っているので使えます。抽選は分岐ごとにやり直されます。木ごとに1回ではありません。
なぜ絞るかというと、性別が強すぎるからです。全部の木が根で性別を使うと、どの木も似た形になり、多数決の意味が薄れます。候補を絞ると、性別を使えない木が出てきて、運賃や客室等級から見た別の分け方が生まれます。
max_features という設定で、既定値は sqrt です。列数の平方根を使うという意味で、6列なら小数を切り捨てて2になります。
この2つのおかげで、1本ずつ違う木ができます。
使うライブラリ
前回と同じ scikit-learn です。決定木が DecisionTreeClassifier だったのに対し、こちらは RandomForestClassifier です。
from sklearn.ensemble import RandomForestClassifier指定する設定はほぼ同じです。決定木の設定に加えて、木の本数を指定します。
| 設定 | 意味 |
|---|---|
| n_estimators | 木を何本作るか。既定は 100 |
| max_depth | 木の深さの上限 |
| min_samples_leaf | 葉に最低何人残すか |
| max_features | 各分岐で見る列の数。既定は sqrt |
891人分のデータで学習させる
どんなモデルができるのかを先に見ます。ここでは891人全員を使います。分けるのは精度を測る段階からです。
木を300本、深さの制限なしで作ります。
model = RandomForestClassifier(n_estimators=300, random_state=0)
model.fit(X, y)
決定木のときと渡すものは同じです。891人分の6列と、その891人の生死だけです。
300本の中身を数える
できたモデルの中身を数えました。
| 300本の中身 | 最小 | 最大 | 平均 |
|---|---|---|---|
| 深さ | 13 | 26 | 18.0 |
| 葉の数 | 138 | 206 | 169.4 |
同じ891人から作ったのに、深さが13から26までばらけています。木ごとに渡される891行の顔ぶれが違い、各分岐で見られる列も違うので、1本ずつ違う木に育ちます。
ここが決定木との大きな違いです。決定木なら条件分岐を全部書き出して読めますが、300本になるとできません。数えられるのは、深さや葉の数といった全体の傾向だけです。
実験の測り方を決める
どの設定でモデルを作るかを決めたいので、設定を変えては点数を測ります。その測り方を先に決めておきます。
測り方が甘いと、たまたま良かっただけの設定を選んでしまいます。
train.csv だけで点数を測る
配られるファイルは2つあります。train.csv には891人分の答えがついていますが、test.csv の418人には答えがありません。答えを持っているのは Kaggle だけで、提出しないと何点か分かりません。
提出は1日10回までです。設定を変えるたびに提出していては足りません。
そこで train.csv を使って、手元で採点できるようにします。
学習データの一部を伏せて、検証データを作る
さきほどは891人全員で学習させました。ところが、そのモデルに891人を予測させても採点になりません。学習のときに答えを見せた人たちなので、当たって当然です。
採点には、学習に使っていない人が必要です。そこで891人を、学習に使う分と採点に使う分に分けます。
| 呼び名 | 何か | 答え |
|---|---|---|
| train.csv | 配られる学習用のファイル | ついている |
| 訓練データ | train.csv の一部。学習に使う | 見せる |
| 検証データ | train.csv の一部。採点に使う | 学習のときは伏せる |
| test.csv | 配られる提出用のファイル | Kaggle だけが持つ |
検証データの答えを消すわけではありません。学習のときに見せないだけです。予測が出たらすぐ自分で照合できます。ここが test.csv との違いです。
10個の組に分けて、採点する組を1つずつ入れ替える
1回だけ分けると、検証データに予測しやすい人が集まるかどうかで数字が動いてしまいます。
そこで891人を10個の組に分けます。各組は89人前後です。そして採点に使う組を1つずつずらしながら測ります。採点しない9組が学習に回ります。
1回あたり、学習が802人、採点が89人です。モデルは毎回作り直します。10回で全員がちょうど1度ずつ採点されます。ここまでで1巡です。
ここから先の数字は、すべてこの作り直したモデルで測ったものです。891人全員で学習させたモデルは、中身を見るために作っただけで、点数には使いません。
from sklearn.model_selection import StratifiedKFold, cross_val_score

cv = StratifiedKFold(n_splits=10, shuffle=True, random_state=0)
scores = cross_val_score(model, X, y, cv=cv)
1巡ぶんの10回を測った結果です。木300本、深さ制限なしの設定です。
| 何回目 | 点数 |
|---|---|
| 1回目 | 0.8556 |
| 2回目 | 0.8539 |
| 3回目 | 0.7753 |
| 4回目 | 0.8876 |
| 5回目 | 0.7753 |
| 6回目 | 0.8315 |
| 7回目 | 0.7640 |
| 8回目 | 0.8202 |
| 9回目 | 0.7416 |
| 10回目 | 0.8315 |
| 10組の平均 0.8136 |
設定も学習のしかたも同じで、採点する組が違うだけです。それでも0.7416から0.8876まで、0.146の幅があります。1組は89人なので、1人の当たり外れが変わるだけで0.0112動きます。
決定木の記事では5組に分けて0.039の幅でしたが、こちらは組を10個にしたぶん1組が89人と小さく、1回ごとの振れが大きく出ます。そのかわり回数が増えるので、平均は安定します。
1巡したらメンバーと乱数を入れ替えて、20巡繰り返す
10組の平均0.8136も、そのまま信じるわけにはいきません。誰がどの組に入るかで変わるからです。
そこで1巡終わるごとに、組の数も1組の人数も変えずに、メンバーの組み合わせだけを入れ替えます。コードでは shuffle=True と random_state がこれを担当しています。
乱数はもう一か所、ランダムフォレスト側にもあります。木ごとの891行の選び直しと、各分岐で見る列の選び方です。こちらを固定したままにすると、1回の引きの良し悪しが数字に残ります。
そこで、メンバーの組み合わせとモデルの乱数を両方とも0から19まで振り、20巡繰り返します。
| 10組の平均 | |
|---|---|
| 1巡目 | 0.8136 |
| 2巡目 | 0.8048 |
| 3巡目 | 0.8024 |
| 4巡目 | 0.8137 |
| 5巡目 | 0.8148 |
| 20巡の最小 | 0.8013 |
| 20巡の最大 | 0.8203 |
0.8013から0.8203まで、0.019の幅です。設定は変えていません。
比べたい設定同士の差は、たとえば木を10本にするか30本にするかで0.004ほどです。巡ごとに0.019動くなら、1巡だけ測っても設定の差は埋もれます。
1巡が10回で、それを20巡やるので、10かける20で200回分の点数が出ます。
seed については後の節でもう一度扱います。
差が0.003未満なら誤差とみなす
200回分を全部まとめて平均します。
| 値 | |
|---|---|
| 200回分の平均 | 0.8108 |
| 1回ごとのばらつき (標準偏差) | 0.0400 |
| 平均自体のぶれ | 0.0028 |
この記事の数字はすべて200回分の平均です。そして平均自体に0.003程度のぶれがあります。
なので、2つの数字を比べるときは0.003を目安にします。差がそれ未満なら、どちらが上とは言えません。
なお、5個の組に分けて5巡する設定も試しましたが、そちらは平均のぶれが0.005でした。巡を増やすとぶれが減り、提出用データとの一致度も上がります。
設定を変えて実験する
決めた測り方で、設定を1つずつ変えて確かめます。木の本数、決定木との差、深さ、seed の順です。
木は何本必要か
まず本数だけを変えて測りました。他の設定は既定値のままです。
| 木の本数 | 検証データ | 標準偏差 |
|---|---|---|
| 1 | 0.7648 | 0.0436 |
| 3 | 0.7918 | 0.0431 |
| 10 | 0.8089 | 0.0387 |
| 30 | 0.8132 | 0.0392 |
| 100 | 0.8128 | 0.0397 |
| 300 | 0.8108 | 0.0400 |
| 1000 | 0.8101 | 0.0398 |
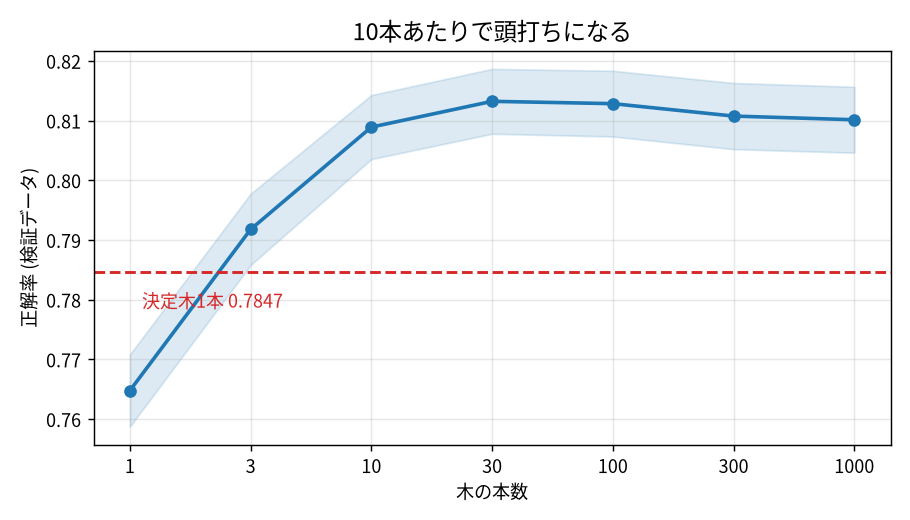
1本から10本にすると0.044上がります。ここが一番大きく動く区間です。
そこから先は横ばいです。10本と1000本の差は0.0012で、判定の目安0.003を下回ります。差があるとは言えません。
つまりこの課題では、10本から30本あれば足ります。1000本にしても時間がかかるだけでした。
標準偏差は1本の0.0436から10本の0.0387まで下がり、そこから先はほぼ横ばいです。1本ずつのばらつきを打ち消す効果も、10本あたりで出きっています。
決定木1本と比べる
どちらも深さを制限しない状態で比べました。
| 構成 | 検証データ |
|---|---|
| 決定木 1本 | 0.7847 |
| ランダムフォレスト 300本 | 0.8108 |
| 差 | +0.0261 |
0.026の差です。判定の目安0.003の9倍近いので、これは差と言えます。
決定木1本を深さ制限なしで作ると、891人を202枚の葉に分けます。そのうち82枚は1人だけです。たまたまいた1人をルールにしてしまうので、初めて見るデータには効きません。
ランダムフォレストにすると、その1人を含む木と含まない木ができます。使うデータを毎回抜き直しているからです。間違え方が木ごとにばらけるので、多数決で打ち消されます。
深さを制限するとどうなるか
決定木では深さ3のあたりが良い結果になります。ランダムフォレストでも同じかを確かめます。
表の RF はランダムフォレストの略です。
| 深さ | 決定木 | RF 300本 | 差 |
|---|---|---|---|
| 3 | 0.8153 | 0.8074 | -0.0078 |
| 5 | 0.8038 | 0.8244 | +0.0206 |
| 8 | 0.8054 | 0.8255 | +0.0200 |
| 12 | 0.7976 | 0.8208 | +0.0232 |
| 制限なし | 0.7847 | 0.8108 | +0.0261 |
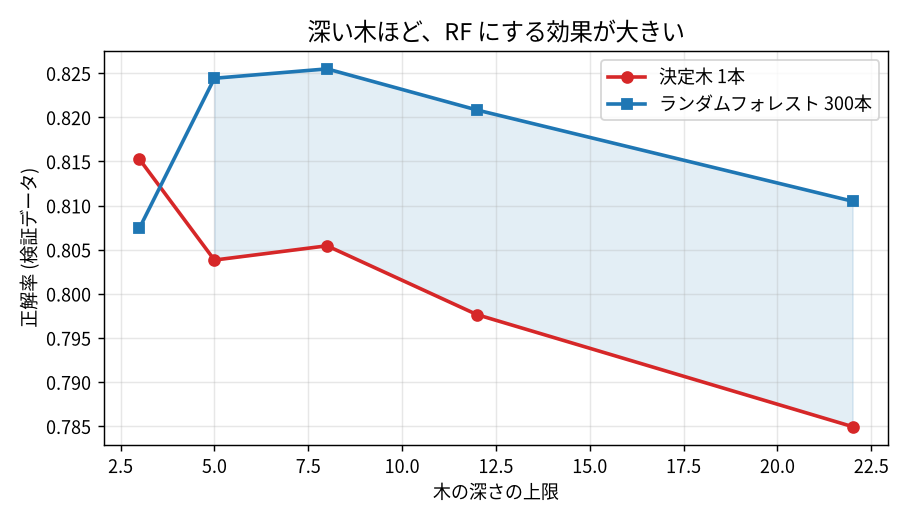
深さ3では、ランダムフォレストの方が負けています。
理由を考えると、浅い木は1本ずつが単純で、何本作ってもあまり違いが出ないからだと思われます。同じような木を集めても、多数決の意味がありません。
深くすると差が開きます。深さ8で0.020、深さ12で0.023です。1本ずつが複雑になるほど、間違え方がばらけて、打ち消し合う効果が出ます。
ランダムフォレストでの最良は深さ8の0.8255でした。決定木の最良0.8153より0.010高い数字です。ただし深さ5の0.8244との差は0.0011しかないので、この2つは見分けがつきません。
seed を変えると点数が変わる
ここまでの数字は200回分の平均でした。ところが提出は1回きりです。1回だけ作ったモデルが平均どおりの成績を出すとは限りません。
原因は乱数です。ランダムフォレストは名前のとおり乱数を使います。
- 木ごとに、891人から891回選び直して学習用のデータを作る。誰が選ばれるかは乱数で決まる
- 各分岐で見られる列を6つのうち2つに絞る。どの2つかも乱数で決まる
コンピュータの乱数は、計算で作られた数列です。その出発点になる数を seed と呼びます。さきほどのコードで random_state に渡した数字がそれです。同じ seed を渡せば毎回まったく同じモデルができるので、結果を再現するために指定します。
問題は、どの seed を選ぶかに根拠がないことです。42 がよく使われるのは、公式ドキュメントやチュートリアルが使っているからという以上の理由はありません。
そこで深さ3の設定のまま、seed だけを変えて3回提出しました。
| seed | 提出用データ |
|---|---|
| 42 | 0.78468 |
| 0 | 0.77990 |
| 1 | 0.77511 |
設定は完全に同じで、変えたのは seed だけです。それでも0.0096の差がつきました。判定の目安0.003の3倍あります。
検証データでも同じことが起きます。seed を0から19まで振って測ったところ、0.8026から0.8109まで動きました。
つまり、1つの seed で出した数字は、その引きがたまたま良かったのか悪かったのか分かりません。
seed は検証データで選べるか
まず思いつくのは、検証データで一番点数が高い seed を選んで提出する方法です。これまでモデルを選んできた手順と同じです。
20個の seed について、検証データの点数と提出用データの点数を並べて相関を見ました。
| 指標 | 値 |
|---|---|
| 相関 | +0.118 |
| 順位相関 | +0.165 |
ほぼ無相関でした。検証データで良かった seed が、提出でも良いとは限りません。seed は選べるものではない、というのが実測の結論です。
seed averaging という手
選べないなら、選ばなくて済むようにします。seed を変えたモデルを何個も作り、予測を多数決でまとめる方法です。seed averaging と呼ばれます。
ランダムフォレストが300本の木で多数決を取るのと同じことを、もう一段上でやります。
- seed 0 から 19 で、ランダムフォレストを20個作る
- 418人それぞれについて、20個それぞれに生存か死亡かを答えさせる
- 多い方を採用する
実際に20個作って比べたところ、418人のうち361人は20個すべて同じ答えでした。割れたのは57人です。seed で変わるのはこの57人で、多数決はそこを20個の意見で決めます。
考え方としては、木を増やすのと同じです。300本のものを20個まとめるのは、6000本のものを1つ作るのとほぼ変わりません。実際、本数を増やすと seed による幅は縮んでいきます。
| 木の本数 | seed を10個振ったときの幅 |
|---|---|
| 30本 | 0.0383 |
| 300本 | 0.0144 |
| 1000本 | 0.0096 |
| 10000本 | 0.0072 |
300本という設定を保ったまま同じ効果を得る方法が、seed averaging です。
モデルを作って提出する
検証で設定が絞れました。ここから先は、その設定で891人全員を使ってモデルを作り直し、提出します。検証中に作ったモデルは点数を取るためのものなので使いません。
提出用データの418人は Kaggle が採点してくれるので、手元で取り分ける必要がありません。使えるデータは全部学習に回します。
seed をどう決めるか
ここで1つ決めることがあります。891人で作り直すときの seed です。検証では20通り振って平均を取りましたが、提出するのは1つのファイルなので、どれか1つに決めなければなりません。
前の節で見た2つの方法を、どちらも試しました。
| 方法 | 中身 |
|---|---|
| ① 検証で一番良かった seed を使う | 20個のうち検証データの点数が最も高かった seed でモデルを作る |
| ② 20個の多数決を取る | seed averaging。418人それぞれ多い方の答えを採用する |
深さ5通り × 方法2つで、10回提出しました。
提出した結果
| 深さ | 検証データ | ① 最良seed | ② 多数決 |
|---|---|---|---|
| 3 | 0.8074 | 0.77511 | 0.78229 |
| 5 | 0.8244 | 0.78708 | 0.78708 |
| 8 | 0.8255 | 0.77751 | 0.77033 |
| 12 | 0.8208 | 0.76794 | 0.76076 |
| 制限なし | 0.8108 | 0.74401 | 0.73923 |
最良は深さ5の0.78708でした。10262チーム中1190位、上位11.6%です。①と②が完全に同じ点数になりました。
検証と提出で順位がずれる
順位を並べるとこうなります。
| 深さ | 検証データ | 提出用データ |
|---|---|---|
| 3 | 5位 | 2位 |
| 5 | 2位 | 1位 |
| 8 | 1位 | 3位 |
| 12 | 3位 | 4位 |
| 制限なし | 4位 | 5位 |
検証で最下位だった深さ3が、提出では2位です。検証では深さ8と0.018の差があり、目安0.003の6倍なので、検証側で誤差ということはありません。
ただ、提出側の数字も1回測ったものです。418人のうち何人で差がついたのかを数えました。
| 比較 | 点数差 | 深さ3だけ当たり | 相手だけ当たり |
|---|---|---|---|
| 深さ3 対 深さ5 | -0.0048 | 8人 | 10人 |
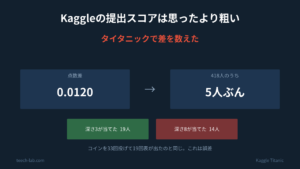
| 深さ3 対 深さ8 | +0.0120 | 19人 | 14人 |
| 深さ3 対 深さ12 | +0.0215 | 24人 | 15人 |
| 深さ3 対 制限なし | +0.0431 | 35人 | 17人 |
深さ3と深さ8は19人対14人です。コインを33回投げて19対14が出るのと同じくらいの偏りなので、どちらが上とは言えません。深さ5と深さ8も18人対11人で、同じく差とは言えませんでした。
提出用データではっきり差がついたのは、制限なしだけです。35人対17人で、これは偏りすぎています。
つまり順位が入れ替わったのではなく、提出側では差が測れていなかった、というのが実態でした。
提出したから正確、ではない
提出用データは418人しかありません。正解率0.78あたりだと、1回の測定の標準誤差は0.020です。
検証側は200回測って平均のぶれを0.003まで下げています。精度は検証側の方が上でした。
| 測る相手 | 回数 | 測定のぶれ | |
|---|---|---|---|
| 検証データ | 891人 | 200回 | 0.003 |
| 提出用データ | 418人 | 1回 | 0.020 |
提出は答えと照合するだけなので、その418人に対する点数は正確です。ただし、そのモデルの実力を測る道具としては粗いものでした。418人はもう増やせないので、繰り返して精度を上げることもできません。
ただし、全部が誤差というわけでもありません。検証は深さ8が深さ3より0.018上だと言っていて、提出では0.012下でした。差の標準誤差0.014に対して2倍以上ずれています。検証が深い木を少し高く見積もっている部分は残ります。
これがなぜ起きるのかは、別の記事にまとめます。
①と②のどちらが良いか
seed の決め方は、深さによって結果が分かれました。
| 深さ | ①と②の差 |
|---|---|
| 3 | ②が0.0072高い |
| 5 | 同点 |
| 8 | ①が0.0072高い |
| 12 | ①が0.0072高い |
| 制限なし | ①が0.0048高い |
②が勝ったのは深さ3だけでした。多数決にすれば良くなる、とは言えません。
ただし②には別の利点があります。①は seed の引きに結果を任せているので、同じ手順をもう一度やっても同じ点数になるとは限りません。前の節で深さ3の seed を3つ試したときは、0.78468から0.77511までばらけました。②の0.78229はその真ん中あたりです。
この記事では②を標準とします。点数が上がるからではなく、測り直しても同じ数字が出るからです。
決定木の最良と比べる
| 手法 | 提出用データの最良 |
|---|---|
| 決定木 (11通り試した) | 0.77990 |
| ランダムフォレスト (10通り試した) | 0.78708 |
0.0072の差ですが、人数で数えると決定木だけが当てたのが8人、ランダムフォレストだけが当てたのが11人でした。ここも差とは言えません。
提出用データの最良同士で比べても、勝ったとは言えない、ということです。
結局、ランダムフォレストは有効だったのか
決定木1本と比べれば、有効でした。
| 構成 | 検証データ | 提出用データ |
|---|---|---|
| 決定木 1本 (制限なし) | 0.7847 | 0.70813 |
| RF 300本 (制限なし) | 0.8108 | 0.73923 |
同じ条件で、検証でも提出でも上回っています。提出側も、決定木だけが当てたのが13人、ランダムフォレストだけが当てたのが26人なので、こちらは差と言えます。
ただし条件があります。深さを制限しない場合に効く、という条件です。深さ3では、検証データでランダムフォレストの方が負けました。
| 深さ3 | 検証データ |
|---|---|
| 決定木 | 0.8153 |
| RF 300本 | 0.8074 |
浅くして1本で戦うか、少し深くして何本も建てるか。どちらの道でも0.78前後には着きます。
| 構成 | 提出用データ |
|---|---|
| 決定木 深さ3 + 葉5人 | 0.77990 |
| RF 深さ5 | 0.78708 |
木を300本建てて提出点数が上がったとは、この418人では言えませんでした。効果が数字ではっきり出ているのは検証データの方です。
まとめ
どこで詰まったか
決定木と同じ前処理がそのまま使えました。文字列は数値に直す必要があり、欠損はそのまま渡せます。
1点だけ、本数を増やすと時間がかかります。
| 木の本数 | 学習にかかった時間 |
|---|---|
| 10 本 | 1 秒 |
| 300 本 | 12 秒 |
| 1000 本 | 40 秒 |
891人でこれなので、数十万行のデータだと本数の選び方が実用面で効いてきます。精度が頭打ちなら、少ない方が得です。
この手法を選ぶ場面
測った結果から言えることです。
- 決定木1本より安定する。特に深い木で効く
- 本数は10から30で足りる。増やしても精度は変わらず時間だけ増える
- 浅い木では効果がない。1本ずつが似てしまうため
- 中身は見られなくなる。300本のif文は読めない
決定木1本なら、中身を全部テキストで出力できます。なぜその予測になったかをたどって説明できます。ランダムフォレストにするとそれが失われます。精度と引き換えに、説明のしやすさを手放すことになります。
次は勾配ブースティングです。同じ木を使いますが、独立に建てて多数決ではなく、前の木の間違いを次の木が直す形で積み上げます。