この記事は次を読んでいる前提で書いています。
検証バージョン: scikit-learn 1.9.1 検証日: 2026-09-29
手元の検証で一番ダメだった設定が、提出したら2番目に良い結果になりました。なんだそれ、と思いました。
検証での差は0.018あります。誤差の目安が0.003なので、その6倍です。たまたまでは片付けられない大きさです。
というわけで原因を調べたのですが、答えは拍子抜けするものでした。誤差です。提出スコアの側が粗すぎて、そもそも差が測れていませんでした。
使うデータ
Kaggle の Titanic を使います。1912年の沈没事故の乗客名簿から、生存したかどうかを当てる課題です。

配られるファイルは2つです。
| ファイル | 人数 | 答え |
|---|---|---|
| train.csv | 891人 | ついている |
| test.csv | 418人 | ない。Kaggle だけが持つ |
train.csv を分けて手元で採点したものを検証データ、test.csv に予測して Kaggle に採点してもらったものを提出用データと呼びます。
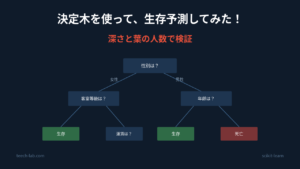
使うモデルはランダムフォレストです。決定木を300本建てて多数決を取る手法で、今回は木の深さの上限だけを変えながら測っています。手法そのものは前の記事で扱ったので、そちらもどうぞ。
何が起きたのか
深さを5通り変えて、検証データの点数と提出用データの点数を並べました。
| 深さ | 検証データ | 提出用データ |
|---|---|---|
| 3 | 0.8074 | 0.78229 |
| 5 | 0.8244 | 0.78708 |
| 8 | 0.8255 | 0.77033 |
| 12 | 0.8208 | 0.76076 |
| 制限なし | 0.8108 | 0.73923 |
順位に直すとこうなります。
| 深さ | 検証データ | 提出用データ |
|---|---|---|
| 3 | 5位 | 2位 |
| 5 | 2位 | 1位 |
| 8 | 1位 | 3位 |
| 12 | 3位 | 4位 |
| 制限なし | 4位 | 5位 |
検証で最下位の深さ3が、提出では2位に上がっています。逆に検証で1位だった深さ8は3位です。
念のため、検証側がいい加減だったわけではありません。891人を10組に分けて採点する測り方を20巡繰り返した、200回分の平均です。平均自体のぶれも0.003まで落としてあります。深さ3の0.8074と深さ8の0.8255は0.018離れているので、この2つが実は同点でした、という話でもありません。
では提出側が正しくて、検証が間違っていたのでしょうか。そう思って調べ始めました。
原因の調べ方
困ったのは、提出スコアからは何も読み取れないことです。418人ぶんの正解率が1つ返ってくるだけで、誰を外したのかは分かりません。
そこで、test.csv の418人の答えそのものを手に入れることにしました。
答えは公開されている
Titanic の課題は、実在の乗客名簿が元になっています。そして1309人ぶんの記録が公開データセットとして配布されていて、生存したかどうかの列もそのまま入っています。つまり答えは最初から世の中に出ています。
名前で突き合わせると、test.csv の418人全員に答えがつきました。ちゃんと対応が取れているかは train.csv の891人で試して確かめています。890人が一致したので、大丈夫そうです。
提出には使いません
もちろん、この答えをそのまま提出すれば満点です。実際、Titanic の順位表の上の方はそういう提出で埋まっています。
ただ、やっても何も面白くありません。この記事では、どこで差がついたのかを調べるためだけに使います。提出したファイルはすべてモデルが予測したもので、答えは一度も混ぜていません。
なぜズレたのか
差は何人分なのかを数える
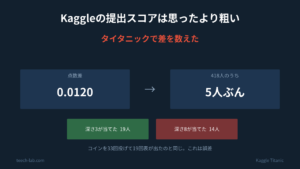
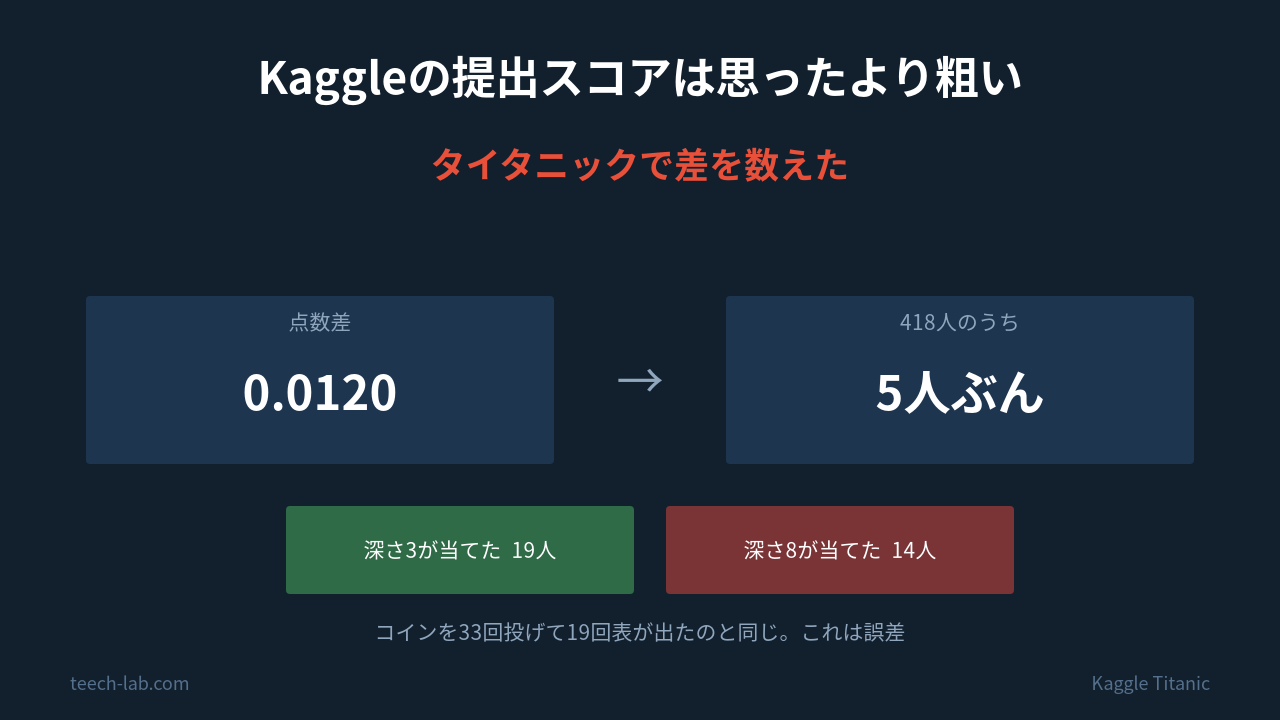
まず気づいたのが、点数差だけ見ていても何人の違いなのか分からない、ということです。418人しかいないので、1人の当たり外れが0.0024もあります。深さ3と深さ8の差0.0120は、5人ぶんでしかありません。
5人と言われると、急に心もとなくなります。そこで2つの提出を並べて、誰が当てたのかを1人ずつ突き合わせてみました。
2つの設定を①と②として比べると、418人は4通りに分かれます。
| ① | ② | |
|---|---|---|
| 両方とも正解 | 正解 | 正解 |
| ①だけ正解 | 正解 | はずれ |
| ②だけ正解 | はずれ | 正解 |
| 両方ともはずれ | はずれ | はずれ |
1行目と4行目は、どちらの設定にとっても同じ結果なので点数差を生みません。差になるのは2行目と3行目だけです。
この2つを数えました。
| ① | ② | 答えが割れた人 | ①だけ正解 | ②だけ正解 |
|---|---|---|---|---|
| 深さ3 | 深さ5 | 18人 | 8人 | 10人 |
| 深さ3 | 深さ8 | 33人 | 19人 | 14人 |
| 深さ3 | 深さ12 | 39人 | 24人 | 15人 |
| 深さ3 | 制限なし | 52人 | 35人 | 17人 |
1行目で言うと、深さ3と深さ5で答えが割れたのは18人。そのうち8人は深さ3だけが当てて、10人は深さ5だけが当てました。差し引き2人ぶん、深さ5の勝ちです。
この差し引きが点数差の正体です。深さ3対深さ8なら19人と14人で5人ぶんなので、5割る418で0.0120。さきほどの点数差と一致します。
問題はこの5人が、33人のうちの19対14から出ていることです。
これ、コインを33回投げて19回表が出るのと同じくらいの偏りです。表の出やすいコインだとは言いません。ただの偶然の範囲です。深さ5と深さ8も29人が割れて18対11なので、これも同じです。
はっきり偏っていたのは制限なしだけでした。35対17なので、こちらは差と見ていいと思います。
つまり深さ3、5、8、12の4つは、提出用データでは誤差です。順位が入れ替わったのではなく、誤差を順位として読んでいただけでした。
提出用データは思ったより粗い
提出用データは418人しかありません。正解率0.78あたりだと、1回の測定の標準誤差は0.020です。
| 測る相手 | 回数 | 測定のぶれ | |
|---|---|---|---|
| 検証データ | 891人 | 200回 | 0.003 |
| 提出用データ | 418人 | 1回 | 0.020 |
深さ3、5、8、12の間の点数差は、どれも0.020より小さいものでした。0.020を超えたのは制限なしとの比較だけです。差が見える大きさではなかった、ということになります。
提出した点数そのものは、その418人に対しては正確です。ただ、モデルの実力を表す数字としては粗いものでした。
とはいえ、全部が測定のぶれで片付くわけでもありません。
検証は深さ8が深さ3より0.018上だと言っていて、提出では0.012下でした。差の標準誤差が0.014なので、2倍以上ずれています。これはさすがに残ります。
どのグループでずれたのか
どこでずれたのかを見たいので、乗客を性別と客室等級で6つに分けました。深さ3から深さ8にしたときの変化を、グループごとに出します。
| グループ | 人数 (train / test) | 検証データ | 提出用データ |
|---|---|---|---|
| 女性 3等 | 144 / 72 | +0.0980 | -0.0417 |
| 男性 1等 | 122 / 57 | -0.0315 | -0.0877 |
| 男性 3等 | 347 / 146 | +0.0137 | +0.0137 |
| 男性 2等 | 108 / 63 | +0.0111 | +0.0159 |
| 女性 2等 | 76 / 30 | -0.0014 | 0 |
| 女性 1等 | 94 / 50 | 0 | 0 |
人数で重みをつけて足すと、検証が +0.0181、提出が -0.0120 になりました。全体の実測値とぴったり一致するので、分解のしかたは合っています。
見てのとおり、動いているのは上の2つだけです。
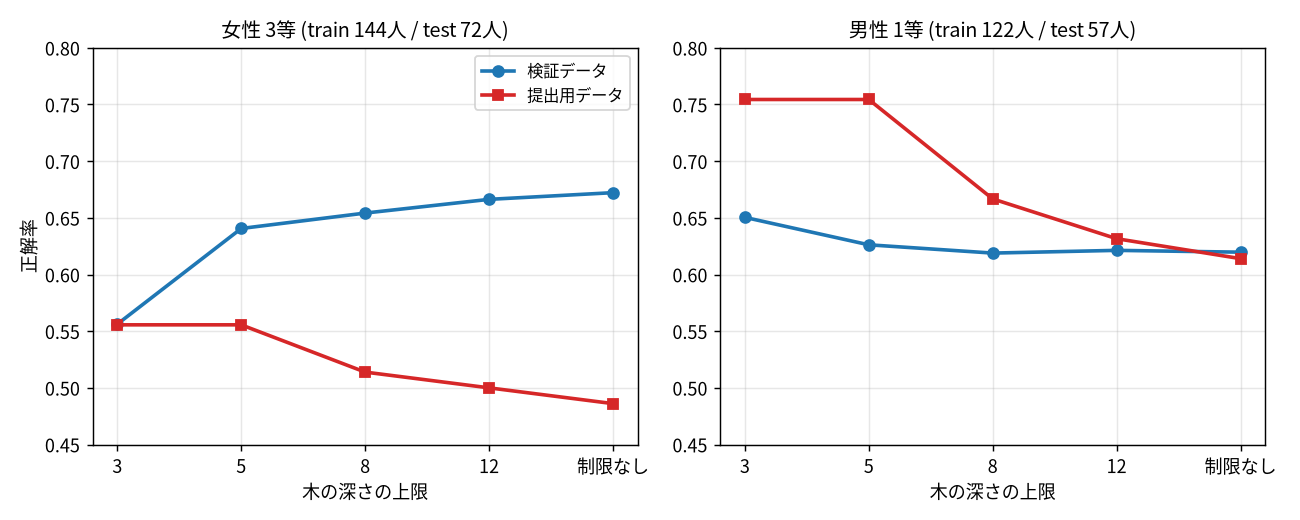
女性3等が分かりやすいです。検証では深さを増やすほど上がり続けて、0.5562から0.6722まで0.116も伸びます。ところが提出では逆に下がります。0.5556から0.4861まで、0.070落ちました。きれいに逆です。
男性1等の方は、検証でも提出でも下がります。向きは同じなのですが、落ち方が違います。検証が0.032、提出が0.088なので、提出側が2.8倍きつく落ちています。
検証全体が深さ8で最良になるのは、要は女性3等の +0.098 が他を押し上げているからです。人数で重みをつけると、検証の伸び +0.018 のうち +0.016 がこのグループから来ていました。
train と test で生存率が違う
なぜ深い木だけが崩れるのか。手がかりは、train の891人と test の418人で、同じグループでも生存率が違うことです。
| グループ | train生存率 | test生存率 | 差 |
|---|---|---|---|
| 女性 2等 | 0.9211 | 0.8000 | -0.1211 |
| 男性 1等 | 0.3689 | 0.2807 | -0.0882 |
| 男性 3等 | 0.1354 | 0.1918 | +0.0563 |
| 男性 2等 | 0.1574 | 0.1270 | -0.0304 |
| 女性 3等 | 0.5000 | 0.4722 | -0.0278 |
| 女性 1等 | 0.9681 | 0.9600 | -0.0081 |
同じ船の同じ事故で、同じ条件のグループなのに、生存率が一致しません。1309人を891人と418人に割っただけなので、割り方次第でこのくらいは動く、ということだと思います。
深い木は、train のグループの中の細かい構造まで合わせにいきます。その構造が test では少し違うので、崩れます。浅い木はグループの大まかな傾向しか見ていないので、崩れ方も小さくて済みます。
分かったこと
逆転は誤差でした。深さ3、5、8、12の4つは、418人では同点です。順位表の上ではきっちり順位がついていますが、その順位に意味はありません。
残っている疑いは1つだけです。検証が深い木を高く見積もっているかもしれない、という点です。ただ、こちらも証拠は弱いものでした。
- 差の標準誤差0.014に対して、ずれは0.030。2倍ちょっとです
- 深さ5通りから2つ選ぶ組み合わせを10通り見ているので、どれか1つがこのくらいずれることはあります
- グループ別の数字も、女性3等の -0.042 は72人のうち3人分、男性1等の -0.088 は57人のうち5人分でしかありません
グループごとの分解は、合計が全体の実測値と一致するので計算としては正しいのですが、1つ1つの数字は数人分の違いです。ここから原因を断定するのは無理があります。
はっきり言えるのは、この418人では判断できない、というところまででした。そして提出する前に見抜く方法も、まだ見つかっていません。
ズレを減らすにはどうすればよかったか
検証データの作り方を変えれば、このズレは減らせるのでしょうか。なぜ女性3等だけがあんな動き方をするのか、ひとつ思い当たることがあったので試しました。
- Hypothesis: 女性3等の改善は、家族が訓練データと検証データに分かれて入ることで起きている
- Why: 3等の女性は家族で乗船しています。運賃はチケット単位なので、家族は同じ運賃になります。深い木は運賃と家族人数の組み合わせを覚えられるので、訓練データにいる姉の答えから検証データにいる妹を当てられます
- Experiment: 同じチケットの人が必ず同じ組に入るように分け直して測る
- Expected Result: 仮説が正しければ、女性3等の深さによる改善が消える
891人のうち344人が、誰かと同じチケットを持っていました。チケットの種類は681です。普通に分けると、この344人は訓練側と検証側にばらばらに散ります。
それなら、同じチケットの人は必ず同じ組に入れてしまえばいい。測ってみました。
| 分け方 | 深さ3 | 深さ5 | 深さ8 | 深さ12 | 制限なし |
|---|---|---|---|---|---|
| 普通 | 0.5556 | 0.6375 | 0.6535 | 0.6687 | 0.6778 |
| チケット単位 | 0.5451 | 0.6139 | 0.6340 | 0.6562 | 0.6549 |
改善、消えませんでした。普通の分け方で +0.122、チケット単位でも +0.110 です。ほとんど変わりません。
仮説は外れです。家族の答えが検証データに漏れているから、という説明では足りませんでした。ここは正直、かなり自信があったので拍子抜けしました。
分け方を変えるだけでは、ズレは減りませんでした。
まとめ
逆転は誤差だった
深さ3、5、8、12の4つは、提出用データでは同点でした。点数の並びだけを見ると順位がついていますが、418人しかいないので、その順位には意味がありません。
はっきり差があったのは制限なしだけです。52人が割れて35対17なので、これは偶然では説明できません。
| 比べたもの | 判定 |
|---|---|
| 深さ3、5、8、12 どうし | 誤差 |
| 上の4つ と 制限なし | 差 |
点数差は人数に直すと判断できる
今回、一番効いたのがこれでした。0.0120という数字を眺めていても何も分かりません。33人が割れて19対14だと分かった瞬間に、これは誤差だなと判断できます。
提出スコアを比べるときは、まず何人ぶんの差なのかを出します。418人なら1人が0.0024です。0.01前後の差は5人ぶんでしかありません。
答えが手元にない場合でも、2つの提出ファイルを比べれば、何人で予測が割れたかまでは数えられます。割れた人数が10人や20人なら、点数差が出ていても誤差を疑った方がよさそうです。
検証データの方が精度は上だった
| 測る相手 | 回数 | 測定のぶれ | |
|---|---|---|---|
| 検証データ | 891人 | 200回 | 0.003 |
| 提出用データ | 418人 | 1回 | 0.020 |
提出したのだから正確だろう、と思っていましたが、逆でした。順位を決めるのは提出スコアですが、設定を選ぶ道具としては検証データの方が細かく見えています。
検証で決めて、提出は答え合わせに使う。順番としてはこうなります。
分からなかったこと
検証が深い木を高く見積もっているように見える部分は、結局説明できませんでした。
検証は深さ8が深さ3より0.018上だと言い、提出では0.012下でした。ずれの合計0.030に対して、提出側の差の標準誤差が0.014です。2倍ちょっとなので、これも偶然の範囲に入ります。
グループ別に分けると、女性3等が検証と提出で逆方向に動いていました。ただしこちらも72人のうち3人分の違いです。原因を語れる大きさではありませんでした。
家族の答えが検証データに漏れている、という仮説は測って外れました。チケット単位で分け直しても、女性3等の改善は消えませんでした。
次にやること
train と test の人員構成の違いを、検証側で再現できないか試します。
train の891人からそのまま10組を作るのではなく、test に近い構成になるように組を作れば、提出する前に気づけるかもしれません。ただ、今回の実測を見るかぎり、そこまでやっても418人では確かめようがない気もしています。
もう1つ、そもそも418人で足りないという問題があります。Titanic は乗客が1309人しかいないので、これ以上は増やせません。参加者が多い大会ほど、この測れなさの上で順位を争っていることになります。