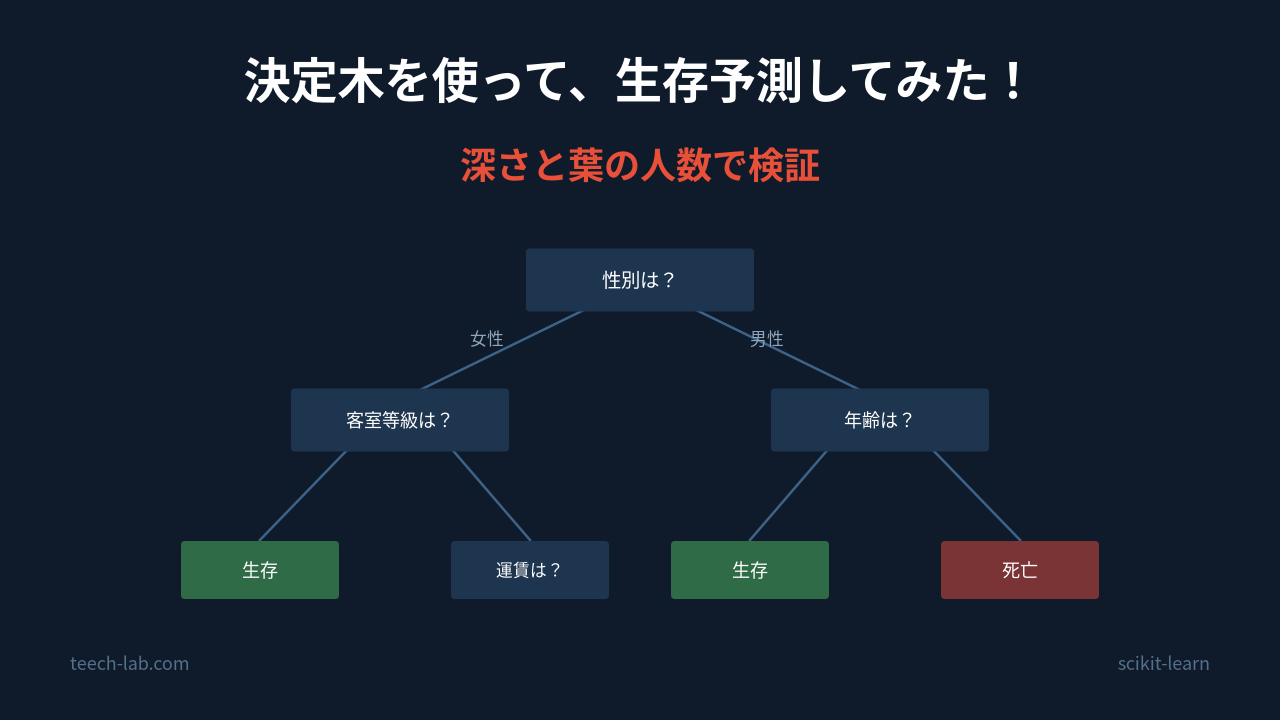
検証バージョン: scikit-learn 1.9.1 検証日: 2026-09-22
決定木は、中身を 人間 が読める形で取り出せる数少ないモデルです。ニューラルネットのように重みの海になることがなく、どの条件でどう分岐したかを全部並べられます。ホワイトボックスモデルと呼ばれる所以です。
では読めると何が分かるのか。題材は Kaggle の Titanic で、891人分の乗客名簿から生存を予測します。
測った結果、深さ3に制限した9行の木が最も精度が高くなりました。制限を外して細かく分けた木より上です。単純な方が強い、という結果を中身を見ながら確かめていきます。
使うデータ
Kaggle とは
機械学習の課題が公開されているサイトです。企業や研究機関が出した予測の課題に対して、世界中の参加者が精度を競います。
課題ごとにデータが配布されていて、参加すれば誰でもダウンロードできます。無料です。
今回使う Titanic は、その中でも入門向けとして用意されているものです。常時開催されていて締切がありません。

データの取得
アカウントを作り、コンペのページで Join してルールに同意すると、データのページ からダウンロードできます。
コマンドで取ることもできます。
kaggle competitions download -c titanic配布されるのは3つのファイルです。この記事で使うのは train.csv だけです。
train.csv               891 行。答えつき
test.csv                418 行。答えなし
gender_submission.csv   提出フォーマットの見本
データの中身
1行が1人で、次の項目が入っています。
PassengerId  乗客の番号
Survived     生き残ったか。0 が死亡、1 が生存。これを予測する
Pclass       客室の等級。1 が上級、3 が下級
Name         氏名
Sex          性別
Age          年齢
SibSp        同乗している兄弟姉妹と配偶者の人数
Parch        同乗している親と子の人数
Ticket       チケット番号
Fare         運賃
Cabin        客室番号
Embarked     乗船した港
891人のうち、生き残ったのは342人で38.4パーセントでした。
Survived が予測したい列です。それ以外の列を手がかりにして、この値を当てます。
決定木とは
条件分岐を積み重ねて分類します。年齢が何歳以上なら右、未満なら左。次は運賃で分ける。そうやって枝分かれを繰り返し、最後にたどり着いた場所で答えを決めます。
普通のプログラミングと違うのは、その条件を人間が書かないところです。何を人間が決めて、何が自動で決まるのかを整理するとこうなります。
人間が決める
  どの列を渡すか          年齢や運賃を使う。氏名は使わない
  木の深さの上限          max_depth
  分かれ方をどう測るか      criterion
  葉に最低何人置くか        min_samples_leaf

自動で決まる
  どの列で分けるか
  しきい値をいくつにするか
  どの順番で分けるか
  深さの上限まで分けるか、途中で止めるか
枠を人間が決めて、中身を計算で埋める形です。
列の優先度は指定できない
どの列を先に見るかは重要そうですが、これを人間が指定する機能はありません。
理由は2つあります。
1つは、総当たりの方が正確だからです。各分岐で全部の列と全部のしきい値を試し、正解が最もきれいに分かれる組み合わせを選びます。891人分の全パターンを評価した結果なので、直感より網羅的です。
もう1つは、優先度が枝ごとに変わるからです。あとで出てくる木を先に見ると、女性の枝では次に客室等級を、男性の枝では次に年齢を見ています。全体で1つの順番があるわけではありません。人間が事前に順番を決める形式では、これを表現できません。
では人間は何もできないかというと、そうではありません。関与できるのは、どの列を渡すかです。
使わせたくない列は外せますし、仮説を新しい列にして渡すこともできます。後者は特徴量エンジニアリングと呼ばれる作業で、これは別に記事を立てます。
使うライブラリ
scikit-learn を使います。Python の機械学習ライブラリで、この分野では定番です。
pip install scikit-learnインストール名は scikit-learn ですが、import するときは sklearn です。名前が違うので最初は戸惑います。
from sklearn.tree import DecisionTreeClassifierこのライブラリには、決定木のほかにランダムフォレストやロジスティック回帰など主要なアルゴリズムが一通り入っています。加えて、欠損値の補完、データの分割、精度の計算まで揃っています。この記事で使うものは全部ここから来ています。
決定木は DecisionTreeClassifier という名前です。指定できる主な設定と、何も指定しなかったときの値です。
criterion           gini    分かれ方の良さをどう測るか
max_depth           None    木の深さの上限。None は制限なし
min_samples_split   2       分岐するのに必要な最小人数
min_samples_leaf    1       葉に最低何人残すか
random_state        None    乱数の種。指定しないと実行ごとに結果が変わることがある
この記事では max_depth と random_state だけ指定します。残りは既定値のままです。
検証バージョンは scikit-learn 1.9.1 です。バージョンによって既定値や挙動が変わることがあるので、手元の値と違う場合はバージョンを確認してください。
891人分のデータで学習させる
決定木がどんなルールを作るのかを先に見ます。ここでは891人全員を使います。分けるのは精度を測る段階からです。
深さを3に制限した木を1本作ります。制限するのは、出力が読める量に収まるようにするためです。
import pandas as pd
from sklearn.tree import DecisionTreeClassifier, export_text

train = pd.read_csv("train.csv")

# 木は数値しか扱えないので、性別だけ 0 と 1 に直す
X = pd.DataFrame({
    "性別が男性": (train["Sex"] == "male").astype(int),
    "客室等級": train["Pclass"],
    "年齢": train["Age"],
    "運賃": train["Fare"],
    "兄弟配偶者の数": train["SibSp"],
    "親子の数": train["Parch"],
})
y = train["Survived"]

tree = DecisionTreeClassifier(max_depth=3, random_state=42)
tree.fit(X, y)
fit が学習です。この1行でモデルができます。
中身を見るには export_text を使います。
print(export_text(tree, feature_names=list(X.columns),
                  class_names=["死亡", "生存"], show_weights=True))
出てきたのは9行の条件分岐
|--- 性別が男性 <= 0.50
|   |--- 客室等級 <= 2.50
|   |   |--- 年齢 <= 2.50
|   |   |   |--- weights: [1.00, 1.00] class: 死亡
|   |   |--- 年齢 >  2.50
|   |   |   |--- weights: [8.00, 160.00] class: 生存
|   |--- 客室等級 >  2.50
|   |   |--- 運賃 <= 23.35
|   |   |   |--- weights: [48.00, 69.00] class: 生存
|   |   |--- 運賃 >  23.35
|   |   |   |--- weights: [24.00, 3.00] class: 死亡
|--- 性別が男性 >  0.50
|   |--- 年齢 <= 6.50
|   |   |--- 兄弟配偶者の数 <= 2.50
|   |   |   |--- weights: [0.00, 15.00] class: 生存
|   |   |--- 兄弟配偶者の数 >  2.50
|   |   |   |--- weights: [8.00, 1.00] class: 死亡
|   |--- 年齢 >  6.50
|   |   |--- 客室等級 <= 1.50
|   |   |   |--- weights: [77.00, 43.00] class: 死亡
|   |   |--- 客室等級 >  1.50
|   |   |   |--- weights: [383.00, 50.00] class: 死亡
これがモデルの全体です。一部ではありません。
weights は、そこにたどり着いた人の内訳です。左が死亡、右が生存の人数を表します。
同じものを Python のif文に書き直すとこうなります。
def 予測(乗客):
    if 乗客.性別 == "女性":
        if 乗客.客室等級 <= 2:
            if 乗客.年齢 <= 2.5:
                return "死亡"        # 該当 2 人
            else:
                return "生存"        # 168 人中 160 人が生存
        else:
            if 乗客.運賃 <= 23.35:
                return "生存"        # 117 人中 69 人が生存
            else:
                return "死亡"        # 27 人中 24 人が死亡
    else:
        if 乗客.年齢 <= 6.5:
            if 乗客.兄弟配偶者の数 <= 2.5:
                return "生存"        # 15 人全員が生存
            else:
                return "死亡"        # 9 人中 8 人が死亡
        else:
            return "死亡"            # 553 人中 460 人が死亡
この関数がそのまま予測器です。学習済みモデルと同じ答えを返します。
判断の根拠が全部見えます。なぜこの人を死亡と予測したのかを、たどって説明できます。これがホワイトボックスと呼ばれる意味です。
予測はif文だが、学習はif文ではない
ここで誤解しやすい点があります。
予測するときの処理は、確かに上のif文と同じです。学習済みの木は、どの列を見るか、しきい値はいくつか、次にどのノードへ行くか、を配列として持っているだけです。predict はその配列をたどっています。
一方、その条件としきい値を決める処理は、if文ではありません。
最初に性別で分けること、次に客室等級を見ること、しきい値を23.35にすること。これらは全部アルゴリズムが決めました。渡したのは891人分のデータだけです。
やっているのは総当たりです。全部の列について、全部の分割候補を試して、正解が最もきれいに分かれるものを選びます。運賃だけでも数百通りのしきい値があり、そのすべてを評価しています。
運賃の23.35という半端な数字は、実際のデータの隙間から出てきた値です。人間が思いつく区切りではありません。
つまり、できあがったものは単純ですが、それを作る過程は単純ではありません。機械学習の仕事はこの探索の部分にあります。
実験の測り方を決める
どの設定でモデルを作るかを決めたいので、設定を変えては点数を測ります。その測り方を先に決めておきます。
測り方が甘いと、たまたま良かっただけの設定を選んでしまいます。
train.csv だけで点数を測る
test.csv には答えがありません。答えを持っているのは Kaggle だけで、提出しないと何点か分かりません。1日10回までという制限もあります。
そこで train.csv だけを使って、手元で採点できるようにします。
学習データの一部を伏せて、検証データを作る
さきほどは891人全員で学習させました。ところが、そのモデルに891人を予測させても採点になりません。学習のときに答えを見せた人たちなので、当たって当然です。
採点には、学習に使っていない人が必要です。そこで train.csv の891人を分けます。
train.csv  891人 (全員に答えがついている)
   │
   ├─ 訓練データ  713人   答えを見せて学習させる
   └─ 検証データ  178人   学習のときは答えを伏せる。予測後に答え合わせする

test.csv   418人   提出用データ。答えは Kaggle だけが持つ
4つ出てきたので整理します。
| 呼び名 | 何か | 答え |
|---|---|---|
| train.csv | 配られる学習用のファイル | ついている |
| 訓練データ | train.csv の一部。学習に使う | 見せる |
| 検証データ | train.csv の一部。採点に使う | 学習時は伏せる。手元にはある |
| test.csv | 配られる提出用のファイル | Kaggle だけが持つ |
配られていないのは test.csv の418人分の答えだけです。行そのものは全部手元にあります。
新しくデータを作るわけではありません。891人を713人と178人に分けているだけです。
検証データの答えは手元にあります。消すのではなく、学習のときだけ見せません。予測が出たらすぐ自分で照合できます。ここが test.csv との違いです。
なぜ隠すのかというと、答えを見せた相手をそのまま採点しても点が高く出るだけだからです。実際、あとで出てきますが、深さ制限なしの木は学習に使ったデータで0.982の正解率を出します。891人を覚え込んだ結果で、実力ではありません。
5つの組に分けて、採点する組を1つずつ入れ替える
178人だけで採点すると、その178人の当たり外れに左右されます。
そこで891人をA、B、C、D、Eの5つの組に分けます。各組は178人前後です。そして採点に使う組を1つずつずらしながら測ります。
| 何回目 | 採点に使う組 | 学習に使う組 |
|---|---|---|
| 1回目 | A | B C D E |
| 2回目 | B | A C D E |
| 3回目 | C | A B D E |
| 4回目 | D | A B C E |
| 5回目 | E | A B C D |
1回あたり、学習が713人、採点が178人です。モデルは毎回作り直します。5回で全員がちょうど1度ずつ採点されます。ここまでで1巡です。
ここから先の数字は、すべてこの作り直したモデルで測ったものです。891人全員で学習させたモデルは、中身を見るために作っただけで、点数には使いません。
from sklearn.model_selection import StratifiedKFold, cross_val_score

cv = StratifiedKFold(n_splits=5, shuffle=True, random_state=42)
scores = cross_val_score(tree, X, y, cv=cv)
1巡ぶんの5回を測った結果です。
| 何回目 | 採点に使う組 | 点数 |
|---|---|---|
| 1回目 | A | 0.8324 |
| 2回目 | B | 0.8258 |
| 3回目 | C | 0.8090 |
| 4回目 | D | 0.8090 |
| 5回目 | E | 0.8483 |
| 5組の平均 | 0.8249 |
設定も学習のしかたも同じで、採点する組が違うだけです。それでも0.8090から0.8483まで、0.039の幅があります。1組は178人なので、1人の当たり外れが変わるだけで0.0056動きます。0.039は7人ぶんの違いです。
1巡したらメンバーを入れ替えて、5巡繰り返す
5組の平均0.8249も、そのまま信じるわけにはいきません。誰がA組に入るかで変わるからです。
そこで1巡終わるごとに、組の数も1組の人数も変えずに、メンバーの組み合わせだけを入れ替えます。
10人を2組に分ける例で言うとこうなります。
| A組 | B組 | |
|---|---|---|
| 1巡目 | 1 3 5 7 9 | 2 4 6 8 10 |
| 2巡目 | 2 3 6 8 9 | 1 4 5 7 10 |
どちらも5人ずつの2組です。顔ぶれだけが違います。
891人でこれをやると、1巡目にA組を採点したときと、2巡目にA組を採点したときでは、採点する相手が別人になります。学習に使う713人の顔ぶれも変わります。
コードでは shuffle=True と random_state がこれを担当しています。random_state の数字を変えると、メンバーの組み合わせが変わります。
5巡ぶん測りました。
| 5組の平均 | |
|---|---|
| 1巡目 | 0.8249 |
| 2巡目 | 0.8059 |
| 3巡目 | 0.8092 |
| 4巡目 | 0.8114 |
| 5巡目 | 0.8137 |
0.8059から0.8249まで、0.019の幅です。設定は変えていません。
比べたい設定同士の差は、たとえば深さ3と深さ5で0.008ほどです。メンバーの組み合わせの運で0.019動くなら、1巡だけ測っても設定の差は埋もれます。
1巡が5回で、それを5巡やるので、5かける5で25回分の点数が出ます。
差が0.005未満なら誤差とみなす
25回分を全部まとめて平均します。
| 値 | |
|---|---|
| 25回分の平均 | 0.8130 |
| 1回ごとのばらつき (標準偏差) | 0.0243 |
| 平均自体のぶれ | 0.0049 |
この記事の数字はすべて25回分の平均です。そして平均自体に0.005程度のぶれがあります。
なので、2つの数字を比べるときは0.005を目安にします。差がそれ未満なら、どちらが上とは言えません。
設定を変えて実験する
決めた測り方で、設定を1つずつ変えて確かめます。木の深さと、葉に残す人数の2つです。
分かれすぎを止める設定は2つある
決めた方法で測っていきます。
細かく分かれすぎるのを止める設定は複数あります。この記事では2つ試します。
深さの上限        何段まで分けるか            max_depth
葉の最小人数      1グループに何人以上残すか     min_samples_leaf
どちらも同じ目的の設定です。止め方が違うだけです。
木の深さ (max_depth) で制御する
深さを3に制限していました。制限を外せば、より細かく分けられるので精度が上がるはずです。
そう予想して測りました。
深さ        検証データ
  1        0.7868
  2        0.7719
  3        0.8130
  5        0.8056
  8        0.8083
 10        0.7987
 15        0.7919
制限なし     0.7888
以降に出てくる数字は、断りがなければすべて検証データでの正解率です。提出用データの点数は、後半でまとめて比べます。
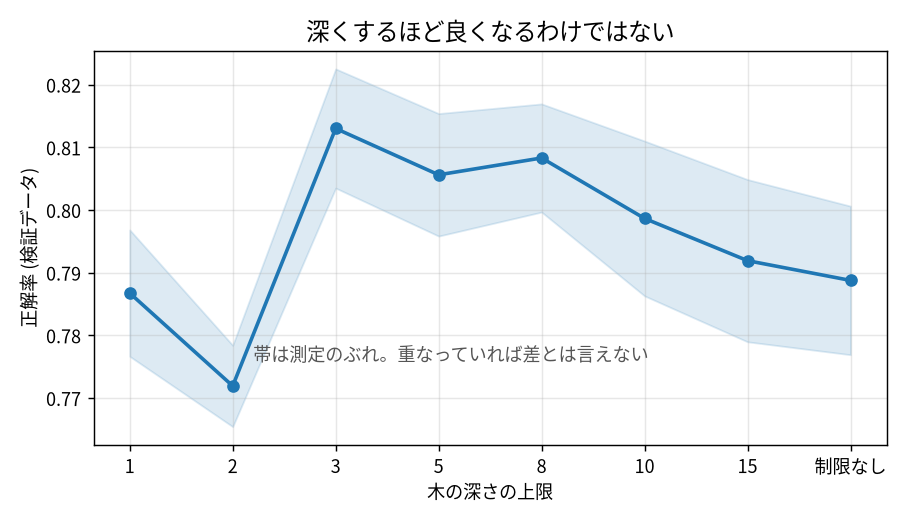
予想は外れました。深さ3が最良で、そこから深くすると下がります。
ただし、さきほど決めた目安が0.005でした。深さ3の0.8130と深さ8の0.8083の差は0.005を下回るので、どちらが上かは断定できません。はっきり言えるのは、深さ10を超えると明確に下がることと、制限なしが最も悪い部類に入ることです。
制限なしの木は、上に全文を載せた9行の木に負けています。
深いと何が起きているのか
理由は、深い木が規則ではなく個別の事例を記録するようになるからです。
制限なしの木がどう分けていたかを数えました。891人を202枚の葉に分けていて、1枚あたり平均4.4人です。そのうち82枚は、たった1人しか入っていませんでした。
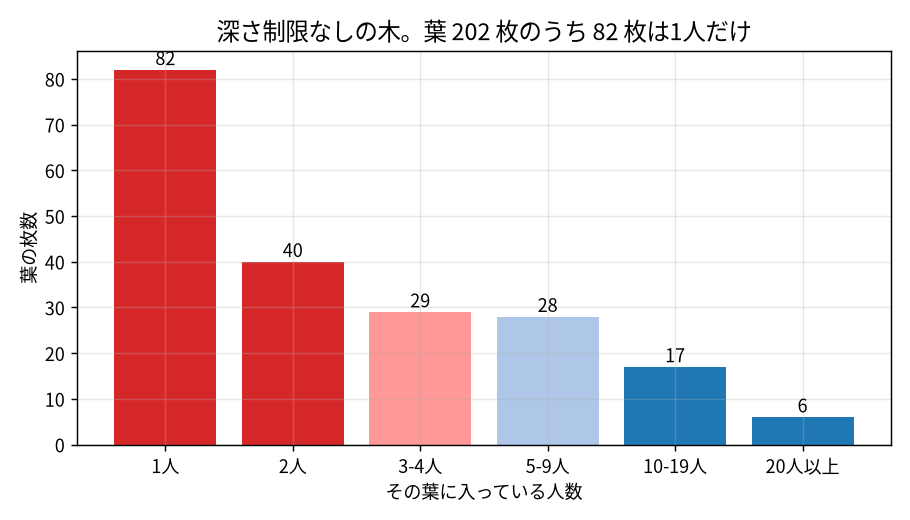
末端の分岐を1つ取り出すと、こうなっていました。
女性 かつ 客室等級が2等以上 かつ 年齢が2.5歳超
     かつ 運賃が28.86以下 かつ 運賃が28.23以下
     かつ 年齢が56歳以下 かつ 兄弟配偶者が1人以上
     かつ 年齢が25歳超 かつ 年齢が27.5歳超
     かつ 年齢が43歳超 かつ 年齢が44.5歳超
  → 該当 2 人。2人とも生存
年齢だけで5回分岐しています。25歳超、27.5歳超、43歳超、44.5歳超、56歳以下。この条件をすべて満たすのは891人中2人でした。
運賃も28.86以下と28.23以下で2回分けています。この0.63の差に意味があるとは思えません。891人の中でたまたまそこに隙間があっただけです。
この2人が生き残ったのは、たまたまかもしれません。ボートの近くにいた、体力があった。データに写っていない理由です。それを木は「こういう条件の人は生存する」というルールにしてしまいます。
訓練データでは当たるのに本番で外れる
さきほどの5分割を使い、訓練データと検証データそれぞれの正解率を深さごとに測りました。
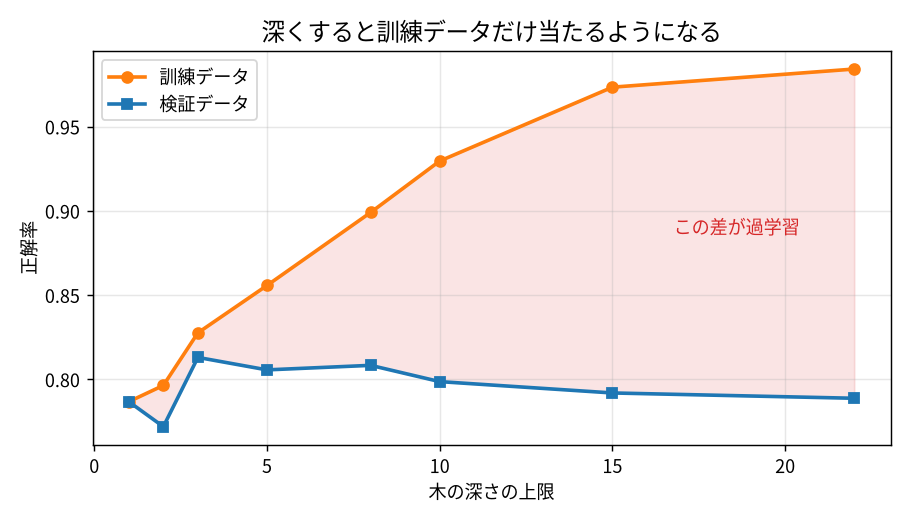
訓練データの正解率は、深くするほど上がり続けます。その2人のために作ったルールが、その2人には必ず当たるからです。
一方、検証データは途中から下がります。初めて見るデータに同じ条件の人が来ても、train の2人とは別人だからです。助かる理由はありません。
この2本の線の開きが過学習です。極端に言えば、葉が891枚になれば1人につき1ルールで、全員の答えを個別に記録しただけの表になります。それはもう規則ではありません。
葉の最小人数 (min_samples_leaf) で制御する
もう1つの止め方です。min_samples_leaf は、葉に最低何人残すかを指定します。
何をしているかというと、分割を認めるかどうかの条件です。分けた結果どちらかが指定人数を下回るなら、その分割は却下されます。
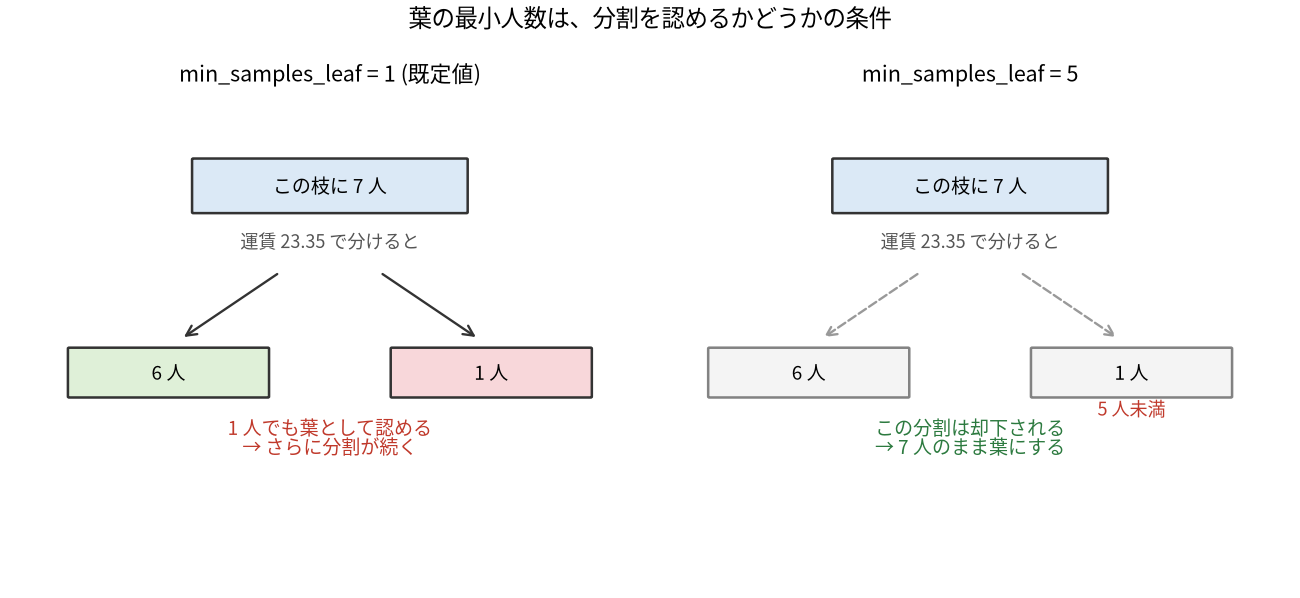
既定値は1です。1人の葉を認めるので、分けられる限り分け続けます。だから制限なしの木で、1人だけの葉が82枚できていました。
5を指定すると、4人以下になる分割は行われません。結果として、どの葉にも最低5人が残ります。
深さは一切制限せず、この設定だけを変えて測りました。
葉の最小人数   検証データ   葉の枚数   実際の深さ
      1人      0.7888      202       22
      5人      0.8139       93       15
     10人      0.8103       56       14
     20人      0.7940       31       11
     50人      0.7982       14        6
葉に最低5人で検証データ0.8139です。深さ3の0.8130とほぼ同じところに着きました。別の止め方で同じ水準に届いています。
葉の枚数を見ると、202枚から93枚に減っています。1人や2人の葉が作られなくなったぶんです。
面白いのは、実際の深さが15もあることです。深いまま精度が出ています。問題は深さそのものではなく、少人数の葉が作られることだった、と分かります。
ただし増やしすぎても下がります。20人や50人にすると、葉が31枚や14枚まで減り、今度は大まかにしか分けられなくなります。
両方を組み合わせる
2つの設定を同時に指定して、16通り測りました。
検証データでの正解率です。
深さ      葉1人     葉5人     葉10人    葉20人
3        0.8130   0.8146   0.8142   0.8025
5        0.8056   0.8081   0.8097   0.7951
8        0.8083   0.8195   0.8099   0.7940
なし      0.7888   0.8139   0.8103   0.7940
検証データで最良は深さ8と葉5人の0.8195でした。単体での最良だった0.8146や0.8139を上回っています。
葉20人の列だけ全体的に下がります。制限が強すぎて、分けられる余地がなくなるためと考えられます。
モデルを作って提出する
検証で候補が並びました。ここから先は、その設定で891人全員を使ってモデルを作り直し、提出します。検証中に作ったモデルは点数を取るためのものなので使いません。
検証データの数字を見ると、上位はこうなります。
深さ8 + 葉5人     0.8195
深さ3 + 葉5人     0.8146
深さ3 + 葉10人    0.8142
葉5人             0.8139
深さ3             0.8130
目安の0.005で判定すると、この5つに差があるとは言えません。どれも候補です。
検証データではここまでしか言えません。ならば提出して確かめます。Titanicは常時開催で、提出すると418人分の採点結果が返ってきます。
11の構成を提出しました。
構成                  検証データ   提出用データ
深さ3 + 葉5人          0.8146     0.77990
深さ3 + 葉10人         0.8142     0.77990
深さ3                 0.8130     0.77511
深さ5                 0.8056     0.77033
葉10人                0.8103     0.76794
葉20人                0.7940     0.76315
深さ8 + 葉5人          0.8195     0.76076
深さ8                 0.8083     0.74162
葉5人                 0.8139     0.72966
深さ10                0.7987     0.72009
制限なし               0.7888     0.70813
検証データは891人を分けて測った正解率、提出用データは418人を Kaggle が採点した正解率です。
検証2位と3位が、提出では1位だった
順位を並べるとこうなります。
| 構成 | 検証データ | 順位 | 提出用データ | 順位 |
|---|---|---|---|---|
| 深さ8 + 葉5人 | 0.8195 | 1 | 0.76076 | 6 |
| 深さ3 + 葉5人 | 0.8146 | 2 | 0.77990 | 1 |
| 深さ3 + 葉10人 | 0.8142 | 3 | 0.77990 | 1 |
| 葉5人 | 0.8139 | 4 | 0.72966 | 9 |
| 深さ3 | 0.8130 | 5 | 0.77511 | 3 |
| 葉10人 | 0.8103 | 6 | 0.76794 | 4 |
| 深さ8 | 0.8083 | 7 | 0.74162 | 8 |
| 深さ5 | 0.8056 | 8 | 0.77033 | 5 |
| 深さ10 | 0.7987 | 9 | 0.72009 | 10 |
| 葉20人 | 0.7940 | 10 | 0.76315 | 7 |
| 制限なし | 0.7888 | 11 | 0.70813 | 11 |
検証で1位だった深さ8と葉5人は、提出では6位でした。
代わりに1位になったのは、検証2位と3位の構成です。どちらも同じ0.77990で並びました。
検証4位の葉5人にいたっては、提出では9位です。上から4番目が下から2番目になりました。
差が小さい範囲では順位に意味がない
上位4つの検証データを見ると、0.8195から0.8139までの範囲にあります。差は0.0056です。
判定の目安は0.005でした。つまりこの4つは、ほぼ目安の中に収まっています。順位が付いてはいますが、差があるとは言えない状態でした。
その4つが提出では1位、1位、6位、9位にばらけました。順位に意味がなかったことが、結果として確認できた形です。
検証は悪いものを除くのには使える
順位は入れ替わりましたが、全部がでたらめだったわけではありません。
最下位の制限なしは、検証でも提出でも10位でした。検証で明確に下だったものは、提出でも下です。
まとめるとこうなります。
- 検証で明確に下だったものは、提出でも下だった
- 検証で差が目安の中に収まっているものは、提出での順位が読めなかった
- 検証で1位だったことは、提出で1位である根拠にならなかった
3番目が今回の発見です。検証の数字は、悪いものを除外するのには使えますが、良いものを確定するには足りませんでした。
結局、決定木は有効だったのか
何と比べるかで決まります。基準を2つ置きました。
                         検証データ   提出用データ
全員を死亡と予測するだけ      0.6162     0.62200
性別だけで判断 (深さ1の木)     0.7868     0.76555
決定木 (設定を変えた11通り)    0.7888     0.70813
                         から0.8195  から0.77990
何もしない基準は0.6162です。891人のうち生き残ったのが38.4パーセントなので、全員を死亡と答えれば61.6パーセント当たります。学習も何もしていません。
そこから決定木は0.81前後まで上げました。差は0.19ほどです。学習には明確に意味がありました。
ただし内訳を見ると、そのほとんどは性別1列で説明がつきます。深さ1、つまり性別で1回分けるだけの木が0.7868です。残りの5列と、2段目以降の分岐を足して稼いだのは0.02から0.03でした。
この課題では、性別が結果のほとんどを決めていたということです。
提出用データを見ると、さらに厳しい結果になります。
性別だけの木が0.76555でした。11通り試した中で、これを上回ったのは3つだけです。残りの8つは性別1列に負けています。
しかもこの0.76555は、Kaggleが提出フォーマットの見本として配っている gender_submission.csv と同じ値です。配布されているサンプルをそのまま出しても同じ点が取れます。
有効だったかという問いには、こう答えられます。
- 何もしない状態からは明確に改善した
- ただし伸びの大半は最初の1分岐で得られた
- 11通り試して、配布サンプルを超えたのは3つだけだった
- 設定をどう変えても提出用データで0.78を超えなかった
精度をもっと上げたいなら、決定木1本では頭打ちです。同じデータでどこまで行けるかは、手法を変えて測る必要があります。
まとめ
どこで詰まったか
1つ目。文字列の列をそのまま渡すとエラーになります。
ValueError: could not convert string to float: 'male'性別のような文字列は、数値に直してから渡す必要があります。この記事では男性かどうかを0と1にしました。
2つ目。欠損値はエラーになりませんでした。
Age には177件の欠損があります。以前のバージョンではエラーになりましたが、scikit-learn 1.3 以降は決定木が欠損をそのまま扱えます。
埋めた場合と埋めない場合を比べました。
欠損のまま      0.8130
中央値で補完     0.8150
差は0.002です。この課題では、埋めてもほとんど変わりませんでした。
この手法を選ぶ場面
測った結果から言えることです。
- 予測の根拠を全部たどれる。なぜその答えになったかを人に説明できる
- 予測は条件分岐をたどるだけ。計算が重いのは学習の側
- 深くすると精度が落ちる。制限が前提になる
- 文字列は渡せない。欠損はバージョンによる
精度だけを求めるなら、実務では木を何本も使う手法に置き換わります。
それでも決定木を選ぶ場面はあります。判断の根拠を人に説明する必要があるとき、そして今回のように過学習が起きているかを自分の目で確かめたいときです。202枚の葉のうち82枚が1人だけ、という事実は、中身が読めるからこそ確認できました。
次は、この木を何百本も作って多数決を取るランダムフォレストを同じデータで試します。1本の木と何が変わるのかを見ます。